监控里CPU负载只有20%-30%、内存也没吃满,网页和后台却越来越慢。此时程序可能不是在计算,而是在等磁盘、网络存储或文件句柄返回。只看CPU和内存,很容易错过真正的等待位置。
用top、vmstat、iostat、pidstat和lsof把“服务卡住”拆成磁盘忙、队列堆积、进程阻塞和句柄不足,再按结果处理,不用直接重启整台服务器。
先看是不是在等I/O
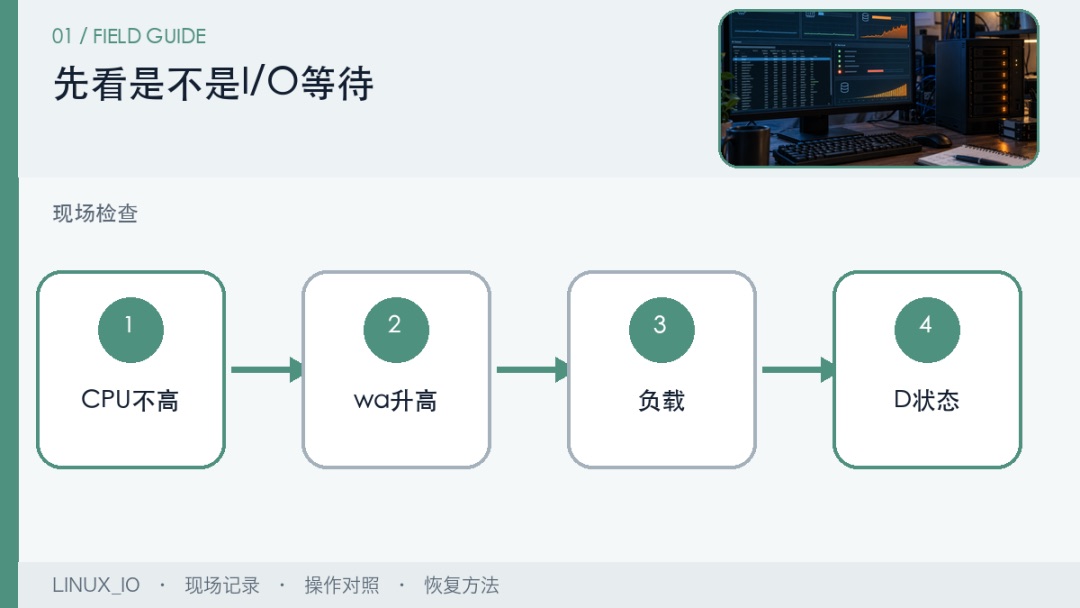
运行top或htop时同时观察CPU的wa比例、负载和进程状态。wa持续升高、负载高但用户态CPU不高,通常说明任务在等待存储或网络文件系统。
先看I/O等待:
- 看wa是否持续升高
- 看负载是否超过CPU线程数
- 找出状态为D的进程
- 记录卡顿开始时间
只在某个瞬间看到wa升高不够,至少连续观察一小段时间,并和服务日志时间对照。
用vmstat和iostat看队列
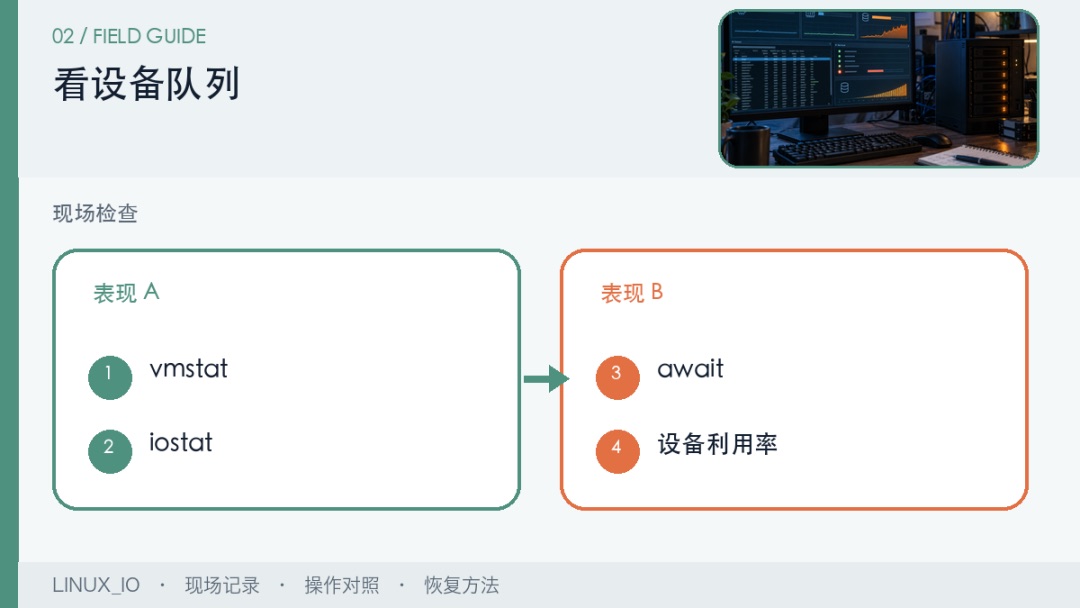
vmstat 1可以看阻塞和等待变化,iostat -xz 1可以看设备利用率、等待时间和队列。不同发行版字段名称略有差异,重点是找出哪个设备在忙、哪个请求等得久。
查看设备队列:
- 连续采样而不是只看一行
- 确认设备名和挂载点
- 看await和队列变化
- 区分本地盘与网络盘
如果一个设备的利用率和等待时间同时上升,先暂停非必要备份、扫描和压缩任务,再继续定位进程。如果是容器把系统盘写满,另有一篇专门讲:Docker 没几个容器系统盘为什么满了。
找到是谁在读写
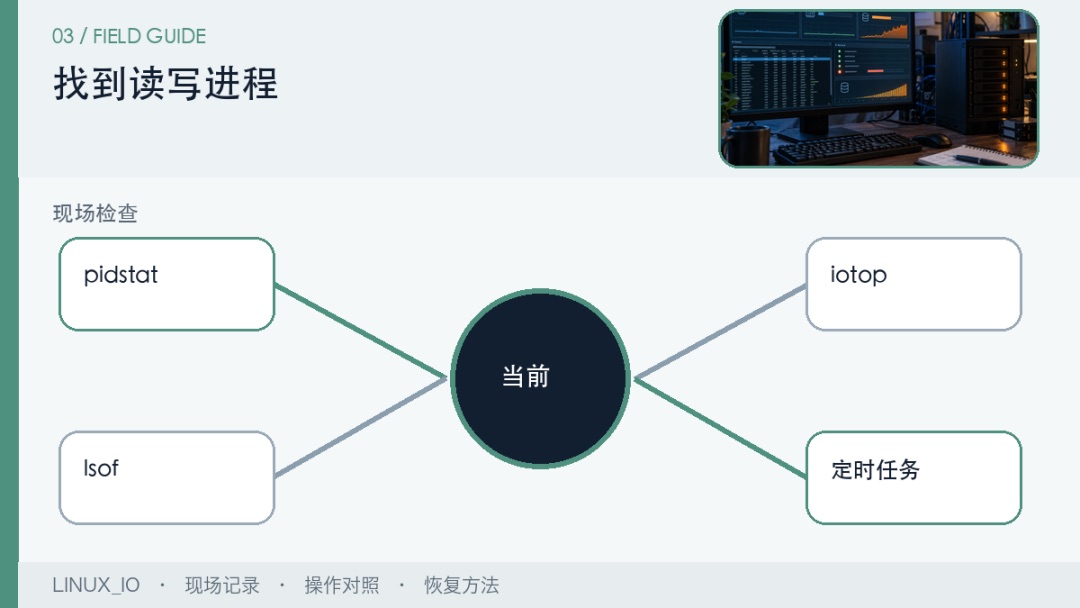
pidstat -d 1可以把读写量对应到进程,iotop适合现场观察,lsof则能看某个进程打开了哪些文件。先找大户,再判断它是备份、日志、数据库、容器还是用户任务。
找到读写进程:
- 按进程看读写量
- 查看打开的目录和文件
- 对照定时任务
- 不要先kill数据库
如果是备份或索引任务占满磁盘,先暂停或调整计划;如果是数据库异常写入,再看数据库日志和磁盘健康。
句柄和挂载也会让服务停住
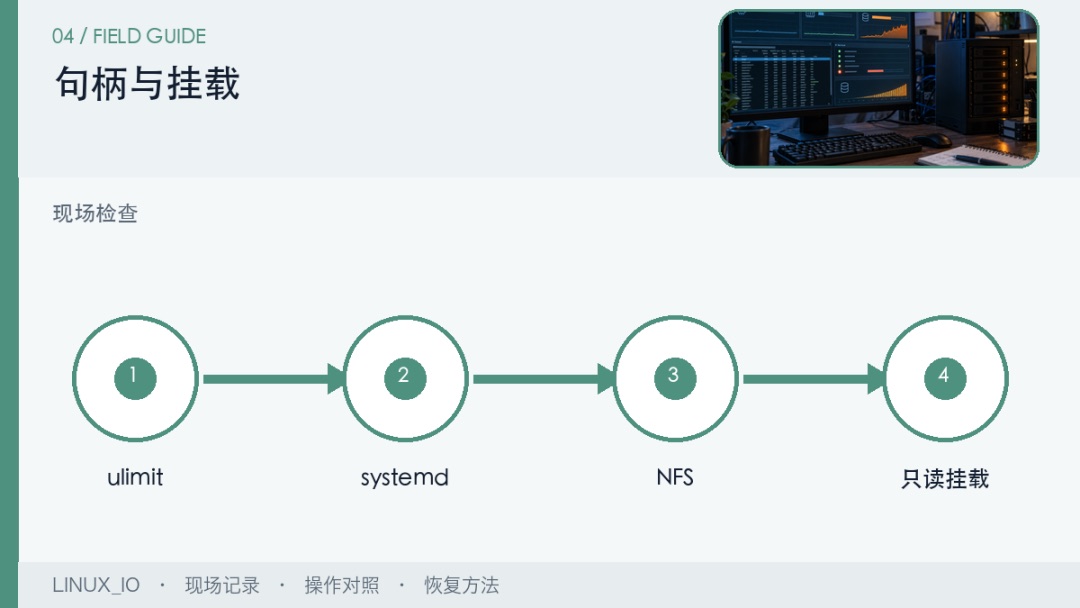
服务可能因为打开文件数达到上限、NFS挂载卡住、磁盘变成只读或临时目录写满而无法继续。用ulimit -n、systemctl show、findmnt和日志一起看,别只盯着磁盘速度。
查句柄和挂载:
- 查看服务文件句柄限制
- 确认挂载是否响应
- 检查是否只读
- 查看/tmp和日志空间
只提高句柄上限不能修好坏盘或失联挂载;先找出哪个资源让进程一直等。
处理后不要只看服务恢复
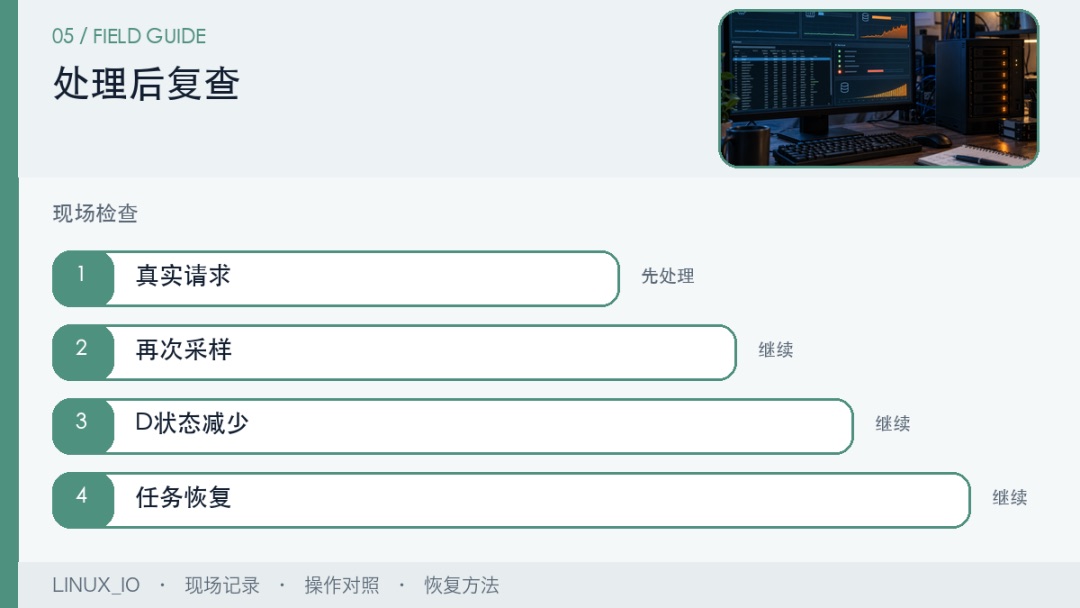
暂停高耗时任务、修复挂载或调整服务并发后,重新观察wa、队列、进程状态和真实访问。网页能打开不代表磁盘等待已消失,至少要让原来卡住的接口和后台任务各跑一遍。
处理后复查:
- 恢复一个真实请求
- 再次采样iostat
- 确认D状态进程减少
- 恢复被暂停的任务
如果短暂恢复后又卡住,把采样结果和任务时间对照,优先处理重复触发的备份、扫描或日志任务。
看到什么结果,先处理哪里
| 现场结果 | 优先检查 |
|---|---|
| CPU不高、wa和await升高 | 磁盘或网络存储等待 |
| 某设备利用率接近100% | 对应读写进程和任务计划 |
| 大量D状态进程 | 挂载、磁盘健康和I/O错误 |
| 服务句柄接近上限 | systemd限制、应用配置和泄漏 |
处理I/O等待时先暂停非必要任务
备份、索引、压缩和扫描往往会在短时间内占满磁盘队列。可以先暂停可延后的任务观察变化,再决定是否调整并发、存储或服务配置;不要把提高CPU或内存当成默认答案。
I/O处理后的最低验收
原来卡住的接口、后台任务和真实文件读写都重新跑一遍,并再次观察wa、设备队列和D状态进程。短暂恢复后又复发时,继续查重复触发的任务。